同款识别(三):分层模型与属性 SOP
本文是《电商同款识别:从属性标准化到可迭代的商品理解系统》的第三篇。文中案例均为合成数据,仅讨论技术方案。
Stage 2 使用文本与多模态双路 FAISS 生成候选 Link,再由 MaskNet 根据价格差、类目、model_name 相似度和包含关系等交叉特征为商品对打分。它把严格属性匹配扩展成了可学习的候选对排序,但最终判断仍然依赖预先设计的数值特征。
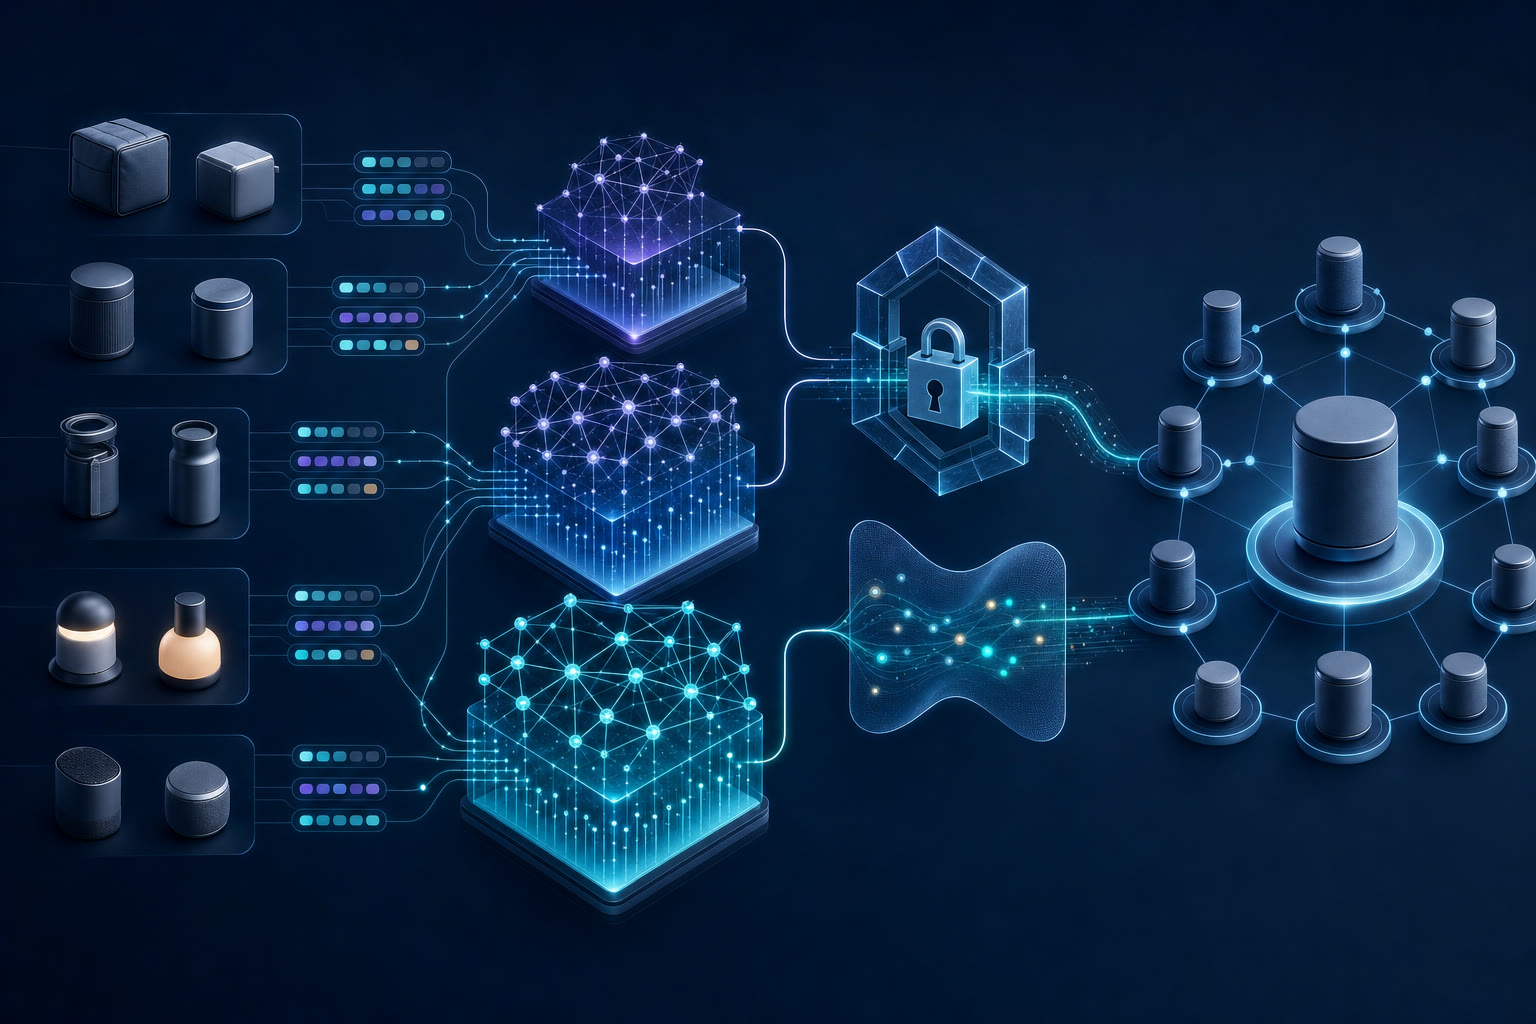
Stage 3 保留双路召回,将 Rank 部分替换为基于大语言模型的逐属性判断。不同属性被路由到不同规模的 Qwen 模型,模型先判断商品对在每个属性上是否一致,再通过 Key-Sales 标准判断规范(SOP)聚合为最终的 Link 结论。Link 通过判断后,仍然沿用 Stage 2 的 K-Means 和簇中心清洗。
1 | Text FAISS ──────┐ |
1. 从 Pair-wise 特征打分到逐属性判断
MaskNet 接收的是已经数值化的 Pair-wise 特征,擅长学习特征之间的交互,但它并不直接阅读商品文本,也不知道某个型号后缀、组合描述或跨字段信息为什么代表同款或非同款。
大语言模型 Rank 将候选商品对重新还原为一个属性判断问题。对于叶子类目 的属性集合 ,分别判断每个属性 :
模型输入包含两件商品与当前属性相关的文本证据、属性定义和判断规则;输出则是该属性的一致、不一致或信息不足。这样,最终 Link 决策不再由一个不可拆分的总分直接给出,而是可以追溯到具体属性。
一个简化的结构化输出如下:
1 | { |
2. 按属性判断复杂度路由模型
不同属性需要的理解能力差异很大。如果所有属性都交给同一规模模型处理,简单属性会消耗不必要的推理能力,复杂属性又可能得不到足够的语义分析。因此,Stage 3 根据属性复杂度进行静态路由。
2.1 7B–8B 级 Qwen:简单属性
小规模模型负责证据直接、值空间清晰的属性。例如:
- 明确出现的品牌或型号;
- 是/否类型的闭合枚举;
- 已完成单位归一的数值;
- 简单别名、大小写和格式差异。
这类判断通常不需要跨越多个字段,也不依赖复杂常识。模型的重点是遵循属性定义,避免把字符串格式差异误判成语义差异。
2.2 Qwen 32B:一般属性
中等规模模型负责需要结合上下文或多个文本片段的一般属性。例如:
- 属性值分散在标题、规格选项和描述中;
- 商家使用缩写、别名或不同语言表达同一个值;
- 需要区分商品本体信息与营销文案;
- 多值属性的顺序不同,但集合语义一致。
这类任务的难点不是长链推理,而是从噪声文本中恢复稳定的属性语义。
2.3 Qwen 72B:复杂属性
大规模模型负责需要组合推理、条件判断或冲突消解的复杂属性。例如:
- 一个属性必须联合多个字段才能确定;
- 标题、规格和描述给出相互冲突的信息;
- 套装、兼容型号和版本后缀改变商品身份;
- 属性判断依赖类目 definition 中的条件规则。
复杂模型的作用不是替代所有判断,而是集中处理那些无法通过局部字符串或单字段信息可靠解决的属性。
属性判断难度与属性重要性是两个彼此独立的维度。一个容易识别的品牌可以是 Key 属性;一个需要复杂推理的套装关系也可能只是 Sales 属性。模型路由解决“需要多强的理解能力”,Key-Sales SOP 解决“该属性对最终结论有多强的约束”。
可以把路由函数写成:
路由粒度是“属性”,而不是“商品”。同一条候选 Link 中,品牌可以由小模型判断,材质由中等模型判断,组合规格则由大模型判断。
3. 用 SOP 约束属性判断
模型规模只决定由谁判断,SOP 才决定按照什么标准判断。SOP 将叶子类目 definition、属性解释、允许的归一方式和最终聚合规则组织成统一约束,避免不同模型各自理解“同款”。
Stage 3 将参与判断的属性分为两类:
- Key 属性:决定商品核心身份的属性;
- Sales 属性:描述具体销售形态、规格或展示差异的属性。
这种划分不是简单地给属性标注重要性,而是为最终 Link 决策定义不同强度的约束。
4. Key 属性:必须一致
Key 属性采用硬约束。对于候选商品对 ,所有 Key 属性都必须判断为 Match:
其中, 是类目 的 Key 属性集合。只要任意 Key 属性明确不一致,或者没有足够证据确认一致,候选 Link 就不能通过 Key Gate。
例如,两件无线耳机的图片和标题都很接近,但 model_name 分别为 T20 和 T20 Pro。如果 model_name 在该类目中属于 Key 属性,那么型号后缀带来的差异不能被图片相似度或其他 Sales 属性抵消。
5. Sales 属性:允许受控放宽
Sales 属性仍然参与判断,但不要求所有属性绝对一致。对于语言表达差异、允许缺失的字段、轻微规格差异或不影响核心身份的销售变化,可以在 SOP 定义的范围内放宽。
将 Sales 属性集合记为 ,可以把逐属性结果聚合成一个一致性分数:
其中, 表示属性权重,Match、Mismatch 和 Unknown 根据 SOP 映射为不同分值。最终 Link 决策同时满足 Key 硬约束和 Sales 软约束:
是类目相关的 Sales 阈值。这里的“放宽”不是忽略 Sales 属性,而是允许少量非核心差异不直接否定整条 Link。
6. 一个合成示例
假设某无线耳机叶子类目定义了以下属性:
| 属性 | 类型 | 商品 A | 商品 B | 判断 |
|---|---|---|---|---|
| Brand | Key | SoundPeak | SoundPeak | Match |
| Model Name | Key | T20 Pro | T20-Pro | Match |
| Product Type | Key | 无线耳机 | Bluetooth Earbuds | Match |
| Color | Sales | 黑色 | 未提供 | Unknown |
| Package Quantity | Sales | 1 套 | Single Pack | Match |
| Included Accessory | Sales | 充电线 | 充电线、替换耳塞 | Mismatch |
简单的 Brand 和标准化型号可以路由给 Qwen 7B/8B;需要理解跨语言表达的 Product Type 可以交给 Qwen 32B;如果配件描述涉及“标配”“赠品”和不同套装规则,则可以由 Qwen 72B 根据类目 SOP 判断。
三项 Key 属性全部一致,因此商品对通过 Key Gate。Sales 属性中存在一个 Unknown 和一个局部差异,但整体仍可按照该类目的 Sales 规则计算,而不会像 Stage 1 的全属性精确匹配一样立即判为非同款。
反过来,如果商品 B 的 Model Name 是 T20 Lite,Key 属性将被判为 Mismatch。即使颜色、包装和配件全部一致,这条 Link 仍会被 Key Gate 拒绝。
7. Link 判断之后仍然进行聚类清洗
大模型只替换 Stage 2 中的 Link Rank,不替代候选召回和后续聚类。通过 Key-Sales SOP 的 Link 继续组成候选关系图,再使用 K-Means 对商品向量聚类。
对于每个候选簇,重新计算平均 Embedding,或者选择成员数量最大的子簇作为主体并计算代表中心。随后移除距离中心过远的成员,以降低局部错误 Link 对整体簇结构的影响。
因此,Stage 3 的完整判断仍然包含两个互补层次:大模型与 SOP 负责检查两件商品之间的属性关系,K-Means 与中心约束负责检查整个商品簇的一致性。
8. Stage 3 的技术变化
三个阶段对“属性”的使用方式逐步变化:
| 阶段 | 候选生成 | Rank / 判断 | 属性约束 |
|---|---|---|---|
| Stage 1 | 同叶子类目 | NER + 规则后的全属性精确匹配 | 所有 definition 属性同等参与 |
| Stage 2 | Text + Multi-modal FAISS | MaskNet Link Rank | 属性被转换为人工特征的一部分 |
| Stage 3 | Text + Multi-modal FAISS | 分层 Qwen 逐属性判断 | Key 硬约束,Sales 受控放宽 |
Stage 3 的核心不是简单地“用大模型替换小模型”,而是改变 Link Rank 的计算方式:先把总判断拆解为可解释的逐属性结论,再通过 SOP 将不同属性以不同强度组合起来。模型负责理解商品信息,SOP 负责保持同款定义的一致性。
9. 术语与数据层级
商品标准化系统经常同时出现 SKU、SPU、子 SPU、商品簇和实例等术语,但不同平台对这些缩写的定义并不完全一致。为了让讨论不依赖某个平台的内部数据模型,本文统一使用以下四个层级:
1 | Product Definition |
9.1 Product Definition:属性类型的定义
Definition 描述的是一个类目需要哪些属性,而不是某件商品的具体值。例如,某个便携式存储设备类目可以定义:
| 属性集合 | 属性类型 |
|---|---|
| Key Attributes | Brand、Model Series |
| Sales Attributes | Color、Capacity |
这里的 Brand、Model Series、Color 和 Capacity 都只是属性类型。Definition 的作用类似于数据 Schema:它规定后续需要提取、比较和存储哪些字段。
9.2 Product Instance:属性值的实例
Instance 是 Definition 被填入具体属性值之后形成的标准商品表示:
1 | { |
Definition 回答“需要描述什么”,Instance 回答“这些属性具体是什么”。同一个 Definition 可以生成许多不同的 Instance。
9.3 Product Cluster:标准商品簇
Product Cluster 是根据类目 definition、Key 属性一致性和 Sales 属性规则构造出来的商品集合。它位于抽象商品身份与原始可售记录之间:既保留稳定的标准属性,也保存簇内成员关系。
Key 属性用于确定核心商品身份;Sales 属性描述簇内允许存在的销售变化。两个 Offer 即使颜色或容量不同,只要 Key 属性一致且 Sales 差异符合该类目的 SOP,仍然可以被组织到同一个 Product Cluster 中。
9.4 Sellable Offer:具体可售记录
Sellable Offer 是最接近原始数据的一层,对应一条可以被检索或购买的商品记录。不同 Offer 可能来自不同数据源,拥有各自的标题、图片、价格和规格选项。
在一些公开资料中,这一层也常被称为 SKU;但严格来说,SKU、商品变体和平台 Listing 的边界会随系统设计变化。本文使用 Sellable Offer,是为了强调它代表“具体记录”,而不是某个平台特有的库存或商品 ID 结构。
9.5 一个完整的合成例子
假设两个 Offer 分别表示同一系列便携式存储设备的不同规格:
| 层级 | 内容 |
|---|---|
| Definition | Key:Brand、Model Series;Sales:Color、Capacity |
| Instance | Brand=Northstar;Model Series=PocketDrive X |
| Product Cluster | 允许 Color=graphite/silver,Capacity=512 GB/1 TB |
| Sellable Offers | offer_a:graphite + 512 GB;offer_b:silver + 1 TB |
这个例子体现了三个容易混淆的概念:
- Definition 是字段集合,不包含具体商品值;
- Instance 是标准属性值,不等于某一条原始商品记录;
- Cluster 保存成员关系,可以关联多个具体 Offer。
10. 技术输出与下游接口
完成 Link 判断、K-Means 聚类和中心清洗后,系统输出的不只是若干商品 ID,而是一组可以被其他模块直接消费的标准商品簇。为避免依赖特定内部名词,本文将这种实体统一称为 Product Cluster。
一个 Product Cluster 可以抽象成:
1 | { |
其中,Key 属性描述簇内商品共同的核心身份;Sales 属性保留允许变化的销售维度;成员列表提供原始商品映射;代表商品或簇中心则为下游检索和展示提供稳定入口。
10.1 不同托管模式的统一商品数据
不同托管模式可能拥有不同来源、格式和完整度的商品信息,但都可以映射到同一套 Product Cluster 表示。上层模块不必重复判断两条商品记录是否属于同款,只需要消费标准类目、Key/Sales 属性、成员关系和代表商品。
因此,同款识别在技术上提供了一层跨数据源的商品标准化接口:输入仍然是不同结构的商品记录,输出则统一为类目相关、属性可解释的商品簇。
10.2 为 Buy Box 构造同款候选集合
Buy Box 需要在多个报价或商品记录之间进行选择,而合理比较的前提是这些候选确实代表同一种核心商品。Product Cluster 可以直接提供这一候选边界:先通过 Key 属性保证商品身份一致,再在簇内比较价格、库存、服务或其他排序信号。
1 | 原始商品集合 |
这样,同款识别负责回答“哪些商品可以放在一起比较”,Buy Box 则只负责回答“在这组可比商品中选择哪一个”。
10.3 用 LLM 生成虚拟商品标题
Product Cluster 还可以进一步构造成一个不对应单一原始商品的虚拟商品。虚拟商品代表整个簇的共同商品身份,并通过成员映射连接到所有原始商品。
标题生成时,将簇内全部商品标题、叶子类目 definition、已经确认一致的 Key 属性,以及可展示的 Sales 属性作为输入,由 LLM 生成一个标准标题:
1 | 簇内全部标题 |
生成过程需要遵循几条约束:
- 标题必须包含能够标识商品身份的 Key 属性;
- 不得补充任何成员商品中不存在的事实;
- 对重复营销词、大小写和单位表达进行归一;
- Sales 属性只有在能够代表簇内商品时才进入标题;
- 存在冲突或无法确认的信息时,优先省略而不是猜测。
例如,某个簇内可能同时出现以下标题:
1 | SoundPeak T20-Pro Bluetooth Earbuds Black |
结合一致的品牌、型号和商品类型后,LLM 可以生成:
1 | SoundPeak T20 Pro 无线蓝牙耳机 |
这个标准标题描述的是 Product Cluster,而不是复制某一个成员商品的文案。它将多条噪声标题压缩成稳定的商品身份表示,也为虚拟商品提供了统一的文本入口。
回顾上一篇: 同款识别(二):双路召回与聚类