同款识别(三):分层模型与属性 SOP
本文是《电商同款识别:从属性标准化到可迭代的商品理解系统》的第三篇。文中案例均为合成数据,仅讨论技术方案。
Stage 2 使用文本与多模态双路 FAISS 生成候选 Link,再由 MaskNet 根据价格差、类目、model_name 相似度和包含关系等交叉特征为商品对打分。它把严格属性匹配扩展成了可学习的候选对排序,但最终判断仍然依赖预先设计的数值特征。
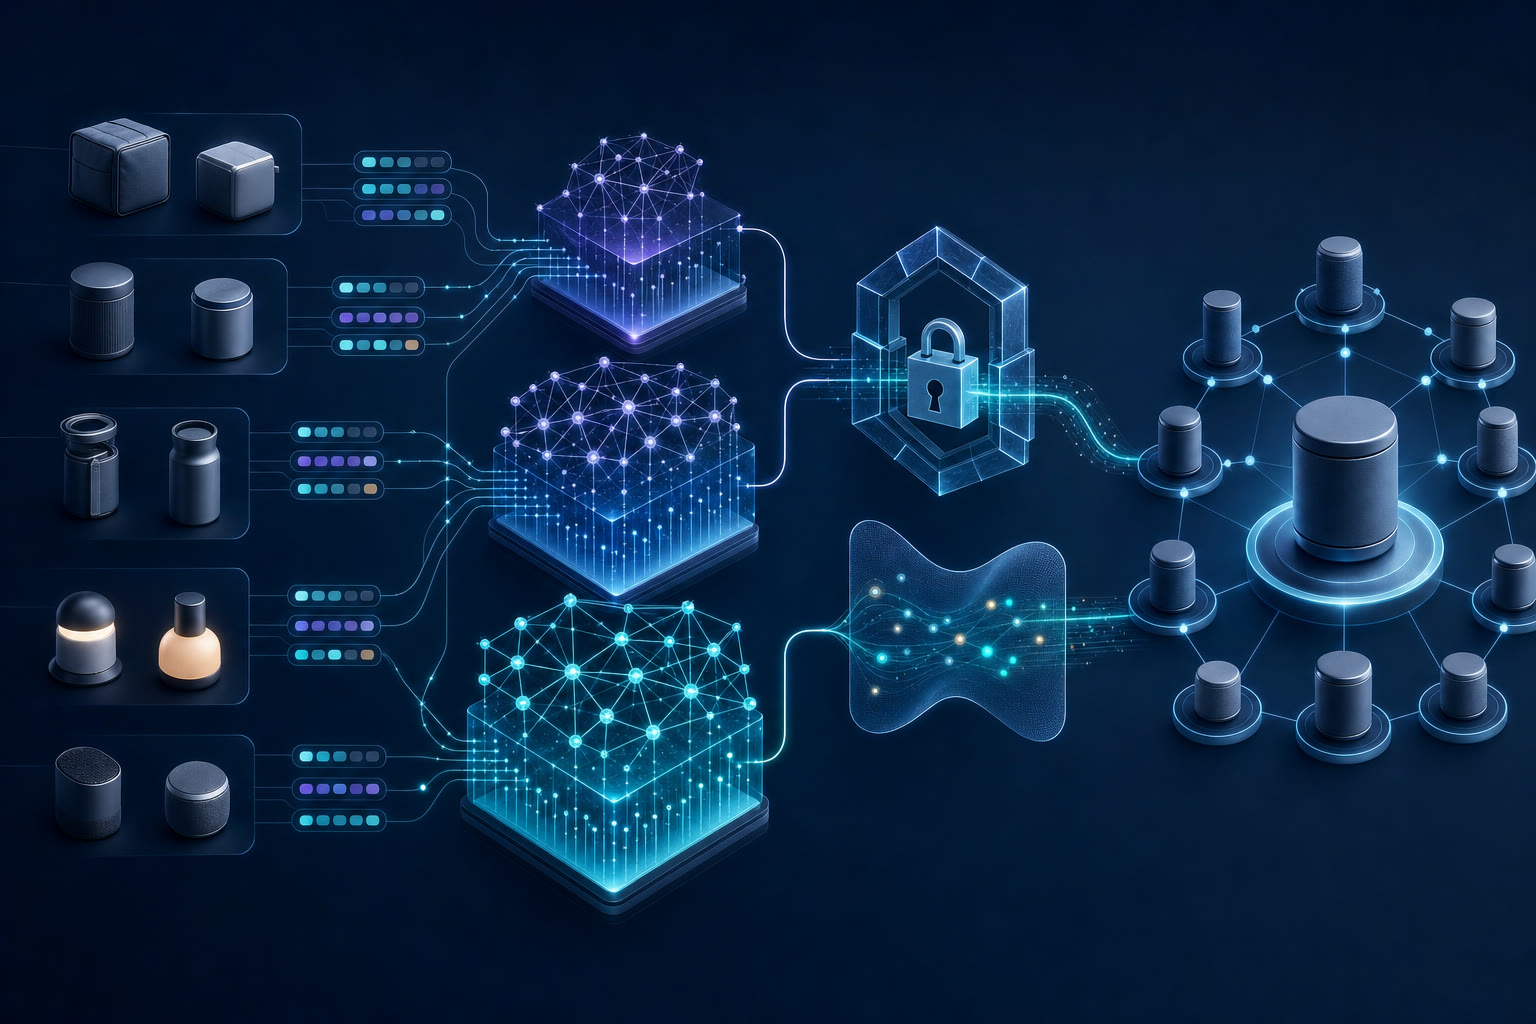
Stage 3 保留双路召回,将 Rank 部分替换为基于大语言模型的逐属性判断。不同属性被路由到不同规模的 Qwen 模型,模型先判断商品对在每个属性上是否一致,再通过 Key-Sales 标准判断规范(SOP)聚合为最终的 Link 结论。Link 通过判断后,仍然沿用 Stage 2 的 K-Means 和簇中心清洗。
系列导航: 同款识别(一) · 同款识别(二) · 同款识别(三)
1234567891011121314151617181920Text FAISS ──────┐ ├─ 候选 LinkMulti-modal FAISS┘ ...
同款识别(二):双路召回与聚类
本文是《电商同款识别:从属性标准化到可迭代的商品理解系统》的第二篇。文中示例均为合成数据,仅讨论技术方案。
Stage 1 将同款识别表示为叶子类目内的属性精确匹配。这套方法可解释,但它的召回能力受类目、NER 与规则覆盖率限制:标题表达不同、属性缺失或图片承载关键信息时,真实同款可能无法得到完全一致的属性向量。
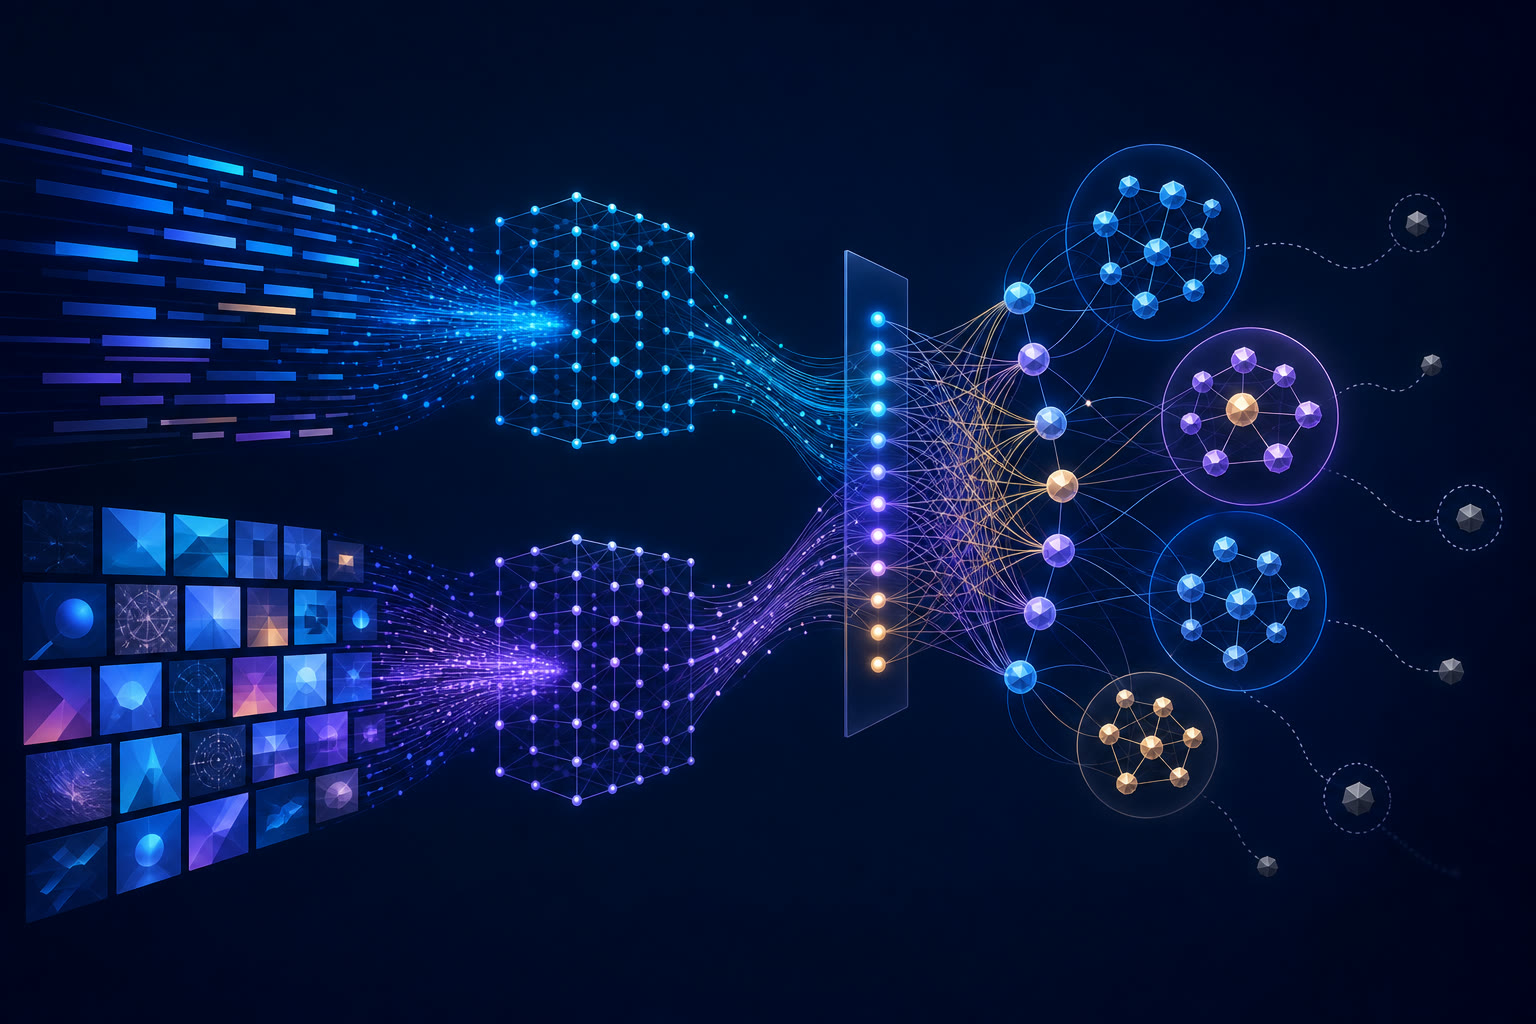
Stage 2 将问题拆成三个连续步骤:先用文本和多模态向量扩大候选集合,再为每条候选 Link 计算同款分数,最后通过聚类和簇中心清洗得到更紧凑的商品簇。
系列导航: 同款识别(一) · 同款识别(二)· 同款识别(三)
1234567891011 ┌─ Text Embedding ── FAISS ─┐商品 ── 特征构造 ──┤ ├─ 候选 Link 合并 └─ Multi-modal ───── FAISS ─┘ ↓ ...
同款识别(一):类目与属性基线
本文是《电商同款识别:从属性标准化到可迭代的商品理解系统》的第一篇。文中案例、字段和值均为合成示例。
同款识别常被误解为“找标题相似的商品”。从技术上看,它首先是一个商品理解问题:两个商品的标题可能完全不同,却表示同一种商品;标题很像的商品,也可能只差一个足以改变商品身份的规格。
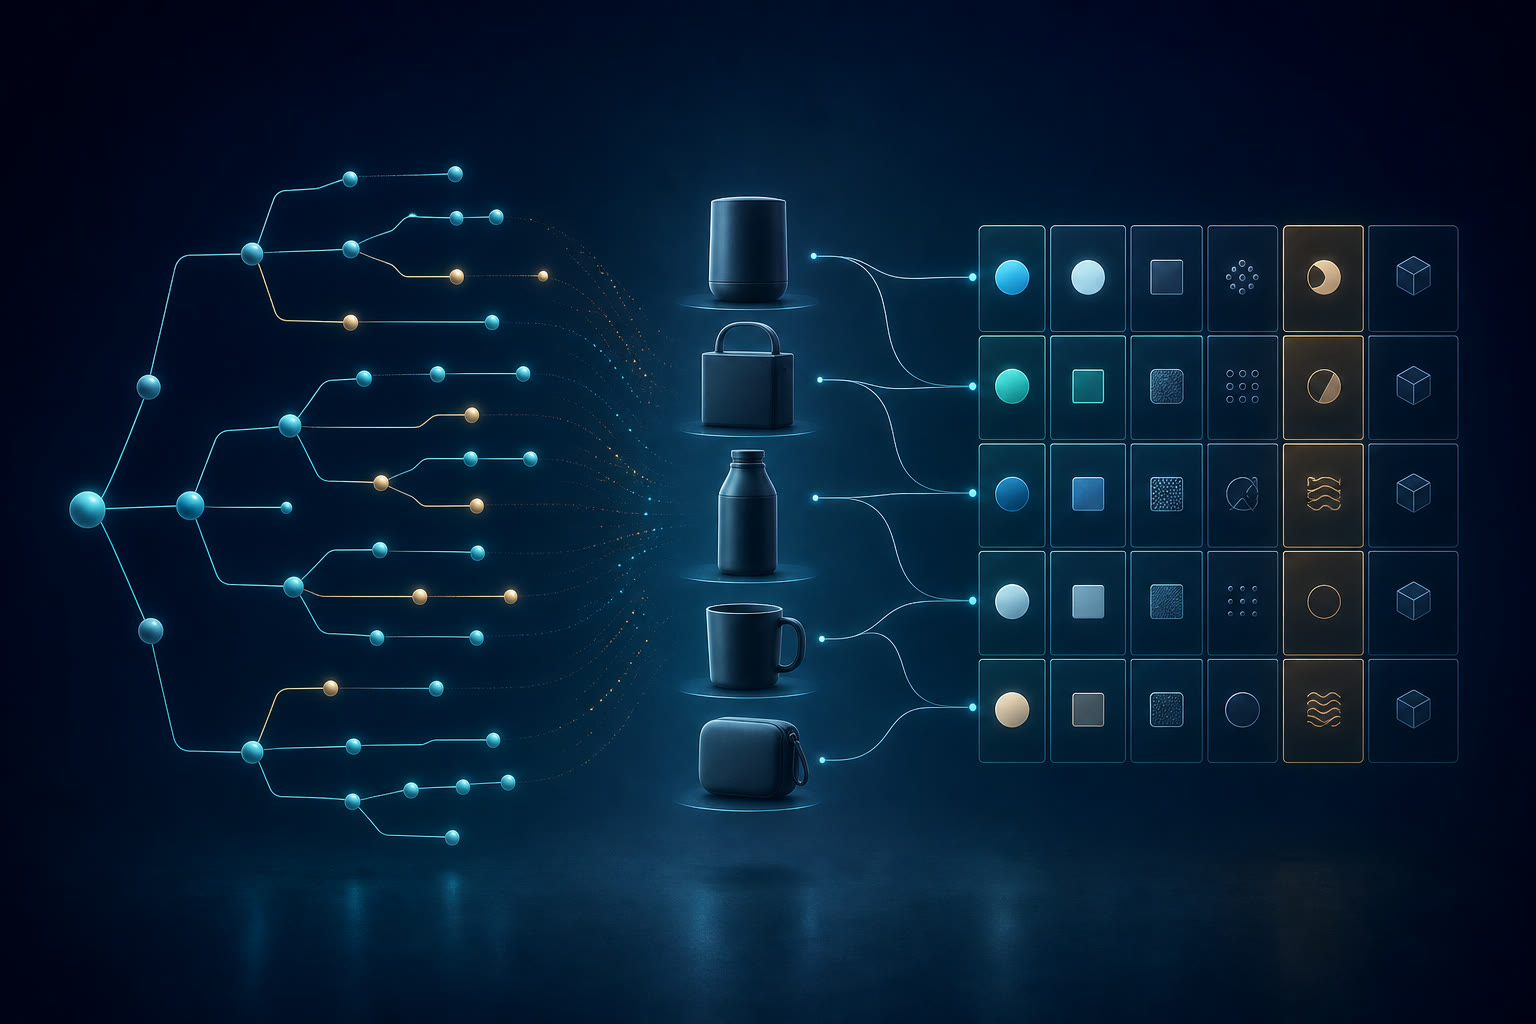
这一阶段的目标不是一次解决所有长尾表达,而是建立一套可解释的比较基线:在给定类目下,明确哪些属性定义同款,哪些属性只是展示差异。
系列导航: 同款识别(一)· 同款识别(二) · 同款识别(三)
1. 问题从哪里开始
1.1 “相似”不等于“同款”
在公开的商品标题里,品牌、营销词、规格、套装数量和颜色常被混合书写;重要信息也可能散落在标题、规格选项和详情描述中。因此,字符串相似度只能作为一个很弱的候选信号。
一个合成例子:
商品
标题
关键差异
A
旅行保温杯 500ml 黑色
容量 500ml
B
大容量随行杯 黑 0.5L
容量 500ml,与 A 可比较
C
旅行保温杯 750ml 黑色
容量不同,不应与 A 直接聚合
这里,“颜色”是否影响聚合取决于下游目标 ...
Dylan's Blog Done!
欢迎来到 Dylan 的博客!
Why?
突然发现在腾讯云续了几年我名字的域名,刚好最近也想整理一些技术分享,于是建了这个个人博客。
How?
听朋友说Nuxt可以建很酷的网站,尝试了半天,Vue从入门到放弃,改用hexo,不得不夸真的是很棒的框架。
Next?
迁移csdn博客ing
无题
爱、主体性与 INFJ
一场关于“靠近是否必然意味着消失”的思想实验
这组问题本身很迷人,像是在给“爱”做一次思想实验的逆向工程。
与其急着把结论收束到“真爱都是假的”这种终极悲观里,不如慢慢拆解 ——
那是哲学陷阱,不是答案。
一、爱上一个人,是爱上那个人的主体性吗?
如果我们说:
爱上一个人 = 爱上那个人的主体性
那这里的主体性,并不是静态的“性格标签”或“优点清单”。
它指的是:
一个人作为能思考、能选择、能表达意志的存在,在世界中展开自己的方式。
你被吸引的,往往不是某个单一特质,而是:
他如何做判断
他如何面对冲突
他如何在关系中靠近或后退
甚至是他身上的节奏、气味、沉默的方式
这是一个动态的、正在发生的东西。
二、在爱上一个人时,我是否把自己变成了客体?
这个问题的核心并不是“爱会不会让我失去自我”,
而是更隐秘的一层:
我在爱的时候,是不是失去了主动性,把决定权交给了对方?
但如果仔细看,会发现一个反直觉的事实:
当你选择去在意、去靠近、去投入,本身就是主体性的体现。
主体性不是“保持不被影响”,
而是:
你决定让什么进入你的世界。
你不是被 ...
搜索常见指标
Precision@K
指检索得到的文档中相关文档所占的比例。
公式 precision=∣{relevant documents}∩{retrieved documents}∣∣{retrieved documents}∣precision = \frac{|\{relevant\,documents \} \cap \{retrieved\,documents\}|}{|\{retrieved\,documents\}|}precision=∣{retrieveddocuments}∣∣{relevantdocuments}∩{retrieveddocuments}∣
Precision@K 表示 ∣{retrieved documents}∣|\{retrieved\,documents\}|∣{retrieveddocuments}∣ = K
Recall@K
指所有相关文档被检索的比例
公式 recall=∣{relevant documents}∩{retrieved documents}∣∣{relevant documents}∣recall = \frac ...